构建中国自主AI工具包 上海临港开发者大会聚焦人工智能基础软件突围
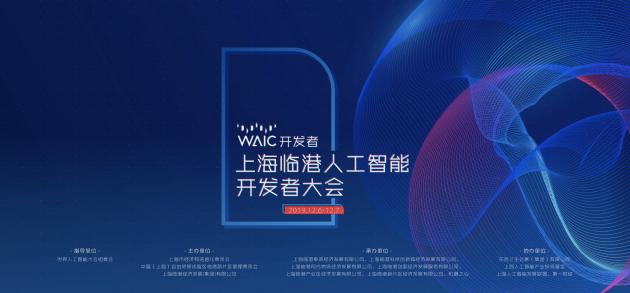
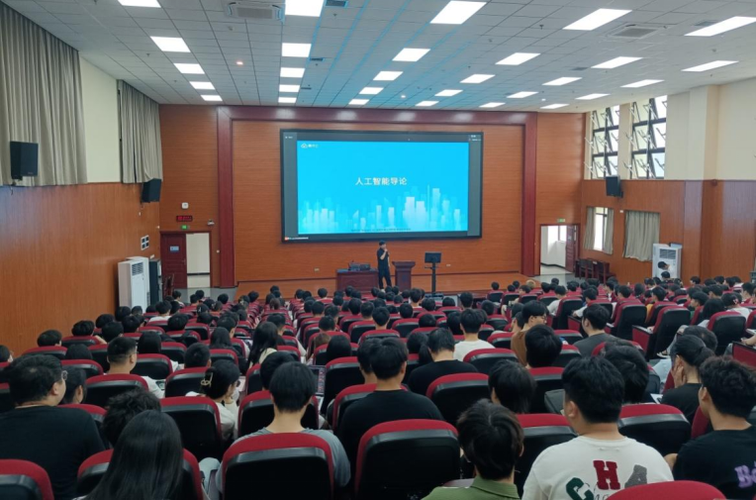
在人工智能技术竞争日益聚焦底层能力的今天,如何打造自主可控的AI基础软件工具链,成为了中国开发者群体面临的核心命题。在上海临港举办的人工智能开发者大会上,一群新锐开发者围绕“构建中国自主AI工具包”展开了深入探讨,试图在人工智能基础软件的深水区寻找突破口。
从“应用繁荣”到“底座焦虑”
过去几年,中国人工智能在应用层呈现出爆发式增长,从计算机视觉到自然语言处理,各类模型和产品层出不穷。繁荣的背后隐藏着一个严峻的现实:大多数开发者依赖的是TensorFlow、PyTorch等海外主导的深度学习框架,训练芯片与算子库也深受英伟达CUDA生态的影响。
“我们可以在别人的地基上盖很漂亮的楼,但地基不是我们的。”一位与会开发者在圆桌讨论中直言。这种“底座焦虑”正在驱动一批技术人转向更底层、更艰苦的基础软件研发。
工具包,而非单一框架
与传统认知不同,新一代开发者认为,突破口不在于复制一个完全对标的深度学习框架,而在于构建一套完整的AI工具包(AI Toolkit)。它应当涵盖从数据处理、模型训练、推理部署到性能调优的全生命周期,并且充分适配国产芯片与多样化算力场景。
在上海临港的讨论中,几个关键方向被反复提及:
- 国产算子库与编译器:屏蔽不同AI芯片的指令集差异,让同一模型能在多种国产加速卡上高效运行。
- 自动化调优与轻量化工具:针对边缘设备和端侧场景,提供剪枝、量化、知识蒸馏的一站式工具。
- 模型可解释性与安全测试套件:在基础软件层面内嵌可信AI能力,而非事后打补丁。
新锐开发者的“非共识”路径
值得关注的是,这批新锐开发者并非全部来自大厂研究院或顶尖高校实验室。不少人是开源社区贡献者、初创公司工程师,甚至是独立开发者。他们的特点是不再追求单一指标的刷榜,而是更关注开发者体验——安装是否足够简单、文档是否友好、API设计是否符合直觉。
“要构建自主工具包,第一条原则是‘可被替代’,但替代的前提是你真的比已有的好用。”一位开发者在闪电演讲中提出。这种务实态度正催生一批小而美的项目:例如专注于混合精度训练的轻量级调度器、支持动态形状编译的图优化器,以及针对国产GPU定制的通信原语库。
临港模式:生态协同的新试验场
上海临港作为人工智能产业的高地,正在尝试为这些散落的火种提供生态支撑。大会上披露的多项举措显示,临港将推动建设开放算子接口标准、互操作性认证机制,以及国产工具链接入激励计划。这意味着一家开发者的工具包如果通过兼容性认证,就能快速接入临港园区内的算力平台与行业用户。
“基础软件的难点从来不是技术本身,而是生态冷启动。”一位长期从事编译器优化的与会专家指出。临港的思路是通过场景开放和应用举证,帮助基础软件跨越“最难的第一公里”。
功夫在诗外
构建中国自主AI工具包,本质是一场关于人才培养、开源文化、产业协同和长期主义的综合工程。它不苛求一夜之间的颠覆,而是默认持续的改进与迭代。在上海临港这场开发者大会的许多角落,我们看到了年轻技术人对“写文档到凌晨三点”、“解一个算子数值溢出bug要两天”这种枯燥工作的尊重与耐心。恰恰是这些超越表面的功夫,将决定自主工具包的深度与韧性。
如若转载,请注明出处:http://www.jzycyp.com/product/39.html
更新时间:2026-10-11 03:04:46